通过档案和一位发明家对话。
博物馆和档案馆开始让访客跟真实人物的 AI 版本聊天。Mort 的设计是只凭档案作答,我的研究就是去查他有没有真的做到。
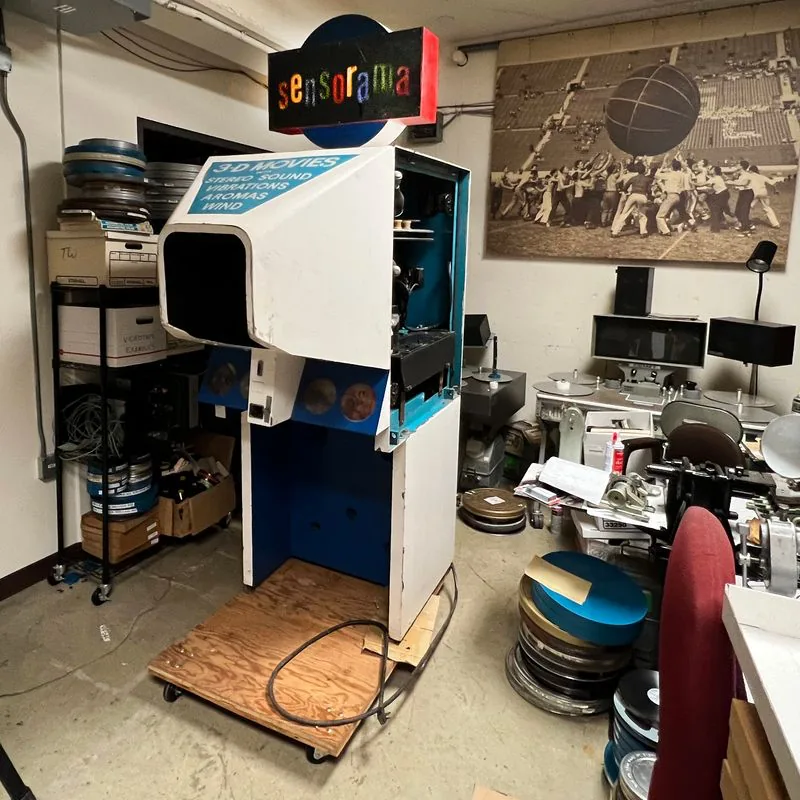
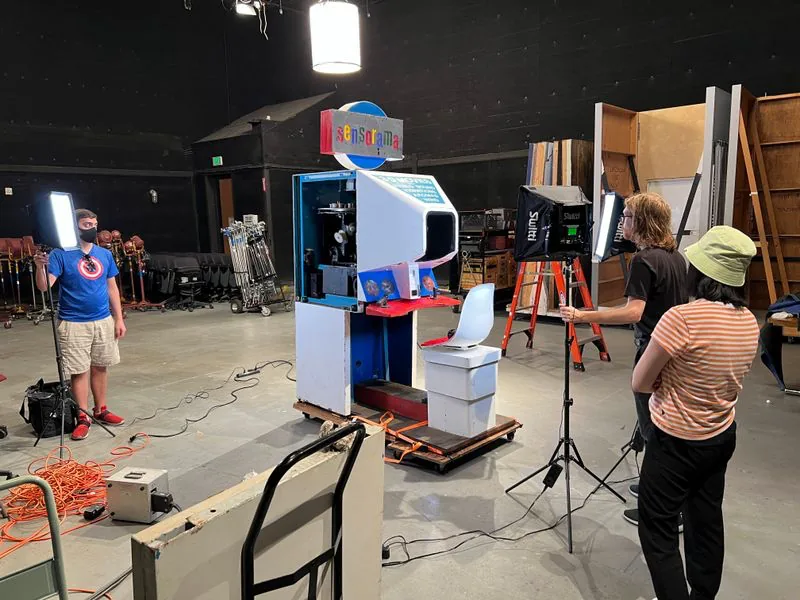
Immersive Archive 是 USC Mobile & Environmental Media Lab 的项目,Scott Fisher 主持,做的是保存虚拟现实的历史。实验室把早年的设备重建成 VR 里可以走进去的模拟,比如 Morton Heilig 的 Sensorama,还有 Ivan Sutherland 的头戴显示器。
Heilig 的文稿是 2017 年到 USC 的,那时他已经去世二十年,现在收在 USC Hugh M. Hefner Moving Image Archive。整批馆藏装了八个箱子,里面有他从 1943 年一直记到 1980 年代的 Idea Books,还有他讲课的录音。
- 馆藏
- 八箱
- Idea Books
- 1943 年到 1980 年代
- 入藏 USC
- 2017
实验室现在把档案从设备往前推一步,推到设备背后的想法。Mort 是一个智能体,以 Heilig 的身份、凭他本人的文稿回答访客提问,每个回答都指出来自档案里的哪个条目。Heilig 的家人同意了这个项目。目的是让人用两种方式了解 VR 的历史:亲手用早年的机器,再去问当年想出这些机器的人。
Mort 背后的知识库,以及怎么核对他的回答。
Mort 是整个实验室的作品,把各个部分接成一个智能体,是大家一起做的。我负责的是把档案变成 Mort 知识库的那条流水线,从转写手稿,到 Mort 作答时用的检索。Mort 的第一人称口吻和他怎么拒答,我也和团队里的其他研究者一起打磨过。VR 重建和 MetaHuman 角色是实验室里其他人做的。
搭 Mort 的过程把我带到了现在研究的题目上:一个智能体以真人身份说话,要怎么核对。我从两条轴来看。档案忠实度,看回答和 Heilig 的档案对不对得上。角色忠实度,看说话和思路像不像他。这两项的评估都是我设计的,正在写成论文,Faithful to the Record, Faithful to the Person? Archive and Character Fidelity in a Conversational Agent of Morton Heilig,目前在准备中。
从 Heilig 的文稿到 Mort 的回答。
Mort 的核心是一个知识库。我在 Dify 里搭的导入工作流,负责把档案灌进去。访客和 Mort 对话时,对话跑在 Estuary 上,这是实验室自己的开源框架,专做实时对话智能体;问题一旦需要档案,它就去调知识库。把知识库接到 Estuary 上,是实验室一起完成的。
从档案到知识库
实验室的档案员先把每个条目数字化,编目时给一个六位的条目编号,记下文件类型。然后工作流按格式把条目分到不同的分支。手写的笔记本和扫描页由视觉模型转写,照片由视觉模型写描述。打字文档直接提取文字,录音做语音转文字。视频从不交给模型:每条视频的描述和链接都是档案员亲手写的。
不管走哪条分支,出来的每段文字都带着条目编号和原文件链接。Mort 能引用档案,靠的是这个;任何人想拿回答去对原页,靠的也是这个。知识库用的是多模态嵌入,每页原件的图像就存在转写文字旁边,检索时可以直接把那一页调出来。
模型做人做自动,不经模型
最难的材料是 Heilig 的手写稿。这部分主要靠多模态语言模型来读,模型也带来它自己的麻烦。有时模型因为内容过滤拒读某一页,所以被拒的页面会转给备用模型。另外,模型的输出永远读起来很顺,一个认错的字和认对的字看着一样可信,校对时很难挑出来。
从问题到回答
访客的问题先到 Estuary,Mort 的角色设定和这轮对话的记忆都存在那里。问题如果需要档案,就被改写成一条搜索语句,知识库按相似度排序,返回看起来最相关的四段。Mort 凭这四段用第一人称作答,并引用它们的条目编号。这几段撑不起一个回答时,他就说档案里没有记载,而不是编一个补上。
不需要档案的问题,比如打个招呼,只凭角色设定和记忆就答了。只有经过知识库的回答才追得到档案。Mort 的知识止于 1997 年 5 月,也就是 Heilig 去世的时候。每条回复在访客看到之前,还要过一道输出护栏。
不需要档案:凭角色和记忆直接回答
档案忠实度与角色忠实度。
这项研究是从实践里长出来的。下面这些问题都是搭建和改进 Mort 时碰到的,评估也是从这些问题里来的。
替一个无法开口的人说话
Mort 用第一人称替一个 1997 年去世的人说话,这个人没法纠正他。正因为这样,Mort 能说什么、不能说什么,从一开始就是设计的一部分。Heilig 的家人同意了这个项目,还会读角色的对话记录,所以 Mort 被做成什么样子,和 Heilig 最亲近的人有发言权。他的知识止于 1997 年 5 月,之后的事不让他评论。文稿里没有答案,他就直说没有,因为访客分不出哪个空白是编出来填上的,哪个是真的空白。凡是出自档案的回答都带条目编号,访客不必只听 Mort 一句话。评估最在意的一种情况,是回答听着像 Heilig,却偏离了记录:这种回答最容易把访客带偏,还把 Heilig 也许从来没有过的看法塞进他嘴里。
两条轴
每个回答从两条轴来核对。档案忠实度问的是:回答和 Heilig 档案原页上写的对不对得上。这一项要一条陈述一条陈述地判,因为一个回答里可能有的有依据,有的没有。档案里没有答案,Mort 说没有,就算守住了档案忠实度;档案在不同时期说法不一,他把两种都讲出来,也算守住了。角色忠实度问的是:回答的口气和思路,像不像 Heilig 自己文字里的那个人。
两条轴一交叉,就是四种情况。访客最难察觉的那种,听着像 Heilig,却偏离了记录,因为它听着有说服力。
角色忠实度
听着像 Heilig,却偏离了档案。
忠于档案,也听着像 Heilig。
档案本身也会错。这类回答另外标出。
Heilig 不可能知道的事,从语言模型漏进来的。
忠于档案,但不是 Heilig 的说法。
档案忠实度
忠实,却还是错的回答
1994 年的一次讲课里,Heilig 说不来梅大轰炸死了十万人。公开记录里的数字远低于此。用档案学的话说,这份讲稿是真的,但在这个数字上不可靠。Mort 忠于记录,用 Heilig 的口吻把这个数字又说了一遍,于是这个回答两条轴都对,却还是错的。这类回答标为来源的问题,和 Mort 自己的失误分开算。这里沿用的是一个区分:忠于来源是一回事,事实准确是另一回事。
把失误追到源头
要知道失误从哪来,就把每个回答沿着一条链往回追,从原页一直到 Mort 的回复,失误记在最早出错的那一环上。常见的 RAG 评估只查两件事:检索出来的段落相关不相关,回答有没有照着段落说。它们把知识库当成现成的,所以覆盖不全、转写出错这类失误,它们查不到。
测试 Mort
测试用一组固定的问题,每题都有标准答案,标准答案对着档案的条目编号。题目从单份文档里就能查到的事实,到要翻好几份文档才答得出的,也有档案根本答不了的。每个回答打四项分:和标准答案是否相符、引用对不对、该拒答时有没有拒答、有没有知识泄漏。另有一位评分者会对其中一部分再打一遍。
档案答不了的问题也分好几种,每种要的回应不一样。
记录空白档案里没有这件事的记录。
直说档案里没有。
问得不够具体没说是哪一年,或哪一本笔记。
反问一句,指的是哪一个。
主观他对某些人或事的感受。
给出不止一种解读,或者说明这是谁的看法。
前提就错了访客问的是他从没做过的工作。
先把前提纠正过来。
拒答在同一组问题上测两个版本。冷拒答只说不知道,对话就此打住。角色内拒答会说记录里没有,顺带指一指档案里相近的东西,口气还是 Heilig 的。
角色这一项,是让 Mort 以角色身份接受访谈,全程逐字记录。评审计划请一位心理学家和 Heilig 的家人来做,他们对着一份改编自 InCharacter 的书面规程读固定的访谈记录。样本很小,所以报告里会写明评审者有几位。
知识库里的转写文字还在校对,校完才会报告结果。
一段脚本演示。
这是按脚本回放 Mort 的设计行为,依据是 Heilig 的几份专利和他 1955 年的一篇文章,都是公开文献。每个问题都先查这些文献,然后智能体要么作答并亮出依据,要么纠正问题,要么拒答并说明为什么。
声明。这是专为本页写的脚本演示,没有接到 Immersive Archive、Dify、Estuary 或任何实验室数据上,这里也没有运行任何语言模型。回答是事先写好的固定文字,转述的是公开文献。它们只用来示意预期的行为,不是 Morton Heilig 的原话,也不是真实智能体的输出。
提问
选一个问题
有的能从文献里答出来,有的答不了。
查过的来源
文献:Heilig, M. L. (1955) The Cinema of the Future, Espacios;美国专利 2,955,156(1960 年)、3,050,870(1962 年)和 3,469,837(1969 年)。回答只转述这几份文献,别的一概不涉及。
Mort 进 VR,开口说话。
现在 Mort 用文字作答。在 Slack 上的一个原型里,他已经能在聊天中把档案图片和视频调出来。实验室正在把他做成 VR 里的 MetaHuman 角色,配上实时语音,让访客可以直接和他说话。
更远的目标,是让 Mort 在头显里带着访客走一遍他自己的档案,像一部沉浸式纪录片,每个回答都能追到它出自的那一页。
目前的成果
- 实验室里一个能跑的 Mort 原型。
- 一篇关于 Mort 的档案忠实度和角色忠实度的论文,在写。
- 从档案搭知识库的这套做法,又用到了 Memory Space: Chinatown AR 上,我在那边参与知识库和语言模型。
技术附录:检索测试与验证循环
检索测试
先查检索,再给回答打分,因为段落一旦找错,后面全都白搭。计划做的测试:
- 该找到的条目有没有找回来,找回来的东西里有多少是真用得上的。
- 把正确的段落挪到列表的不同位置,看 Liu et al. (2024) 报告的那种现象,段落排在中间时准确率下降,在这批档案上是否也成立。
- 增加返回的段落数,同时盯着召回率和回答质量两个指标。
- 用同样的设置在另一批档案上跑一遍,把模型的因素和这批馆藏的因素分开。
相似度搜索分不出来源的好坏。一份专利和二十年后写的一条笔记,在检索器眼里可能没有区别,所以计划给条目按来源类型打标签,让专利排在事后回忆前面。
角色评审
评审打分的维度有语言风格、知识、性格和思维方式,这是角色扮演智能体常用的四项;因为 Mort 是从档案里建出来的历史人物,又加了两项:他怎么处理分歧,档案用完了他怎么办。访谈方法来自 InCharacter,那套方法是在虚构角色上验证的,性格标签来自众包。到了 Heilig 这里,参照换成他自己的文字和认识他的人的判断:证据更硬,样本却小得多。
一轮验证
- 冻结一个版本,所有设置钉死。
- 跑固定题集,两种拒答都跑。
- 每个回答在两条轴上都标。
- 每个失误追到链上的那一环。
- 设置、分数、失误标签和评审者的笔记,连同版本一起记录。
然后只改一个变量,开始下一轮,这样两轮之间的差别只可能有一个原因。
转写
不同厂商的模型转写同一页,结果各不相同。这是每一页都要对着原件校对的又一个理由。