El viejo Chinatown, de vuelta donde estuvo.
Memory Space devuelve la historia del primer Chinatown de Los Ángeles al suelo donde estuvo, y sus personajes responden a partir de los propios registros de la comunidad.
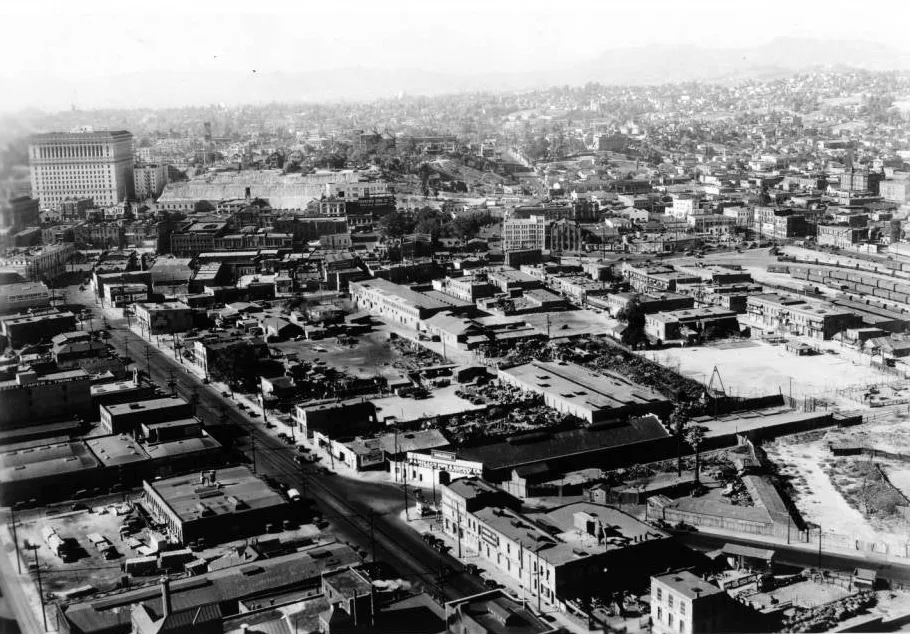
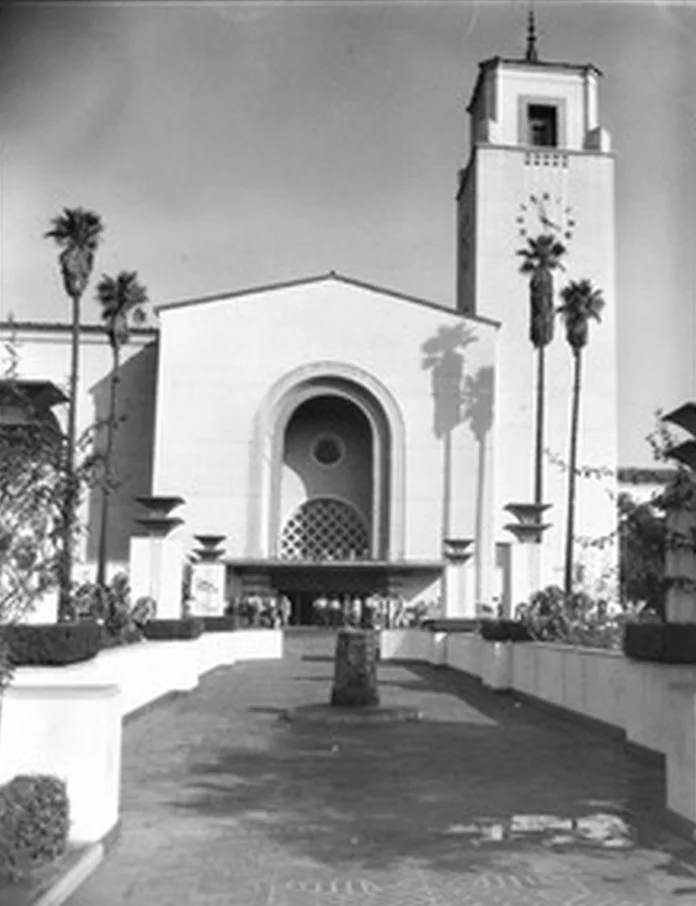
Memory Space: Chinatown AR es un proyecto de realidad aumentada para móviles del USC Mobile and Environmental Media Lab, dirigido por Scott Fisher y William Deverell. De pie en Union Station, el visitante levanta el teléfono y ve fotografías históricas del primer Chinatown de Los Ángeles colocadas sobre los puntos exactos donde se tomaron, siguiendo los pasos de los fotógrafos originales. Unos portales se abren a escenas de calle tridimensionales de la antigua comunidad, donde los visitantes se encuentran con personajes interactivos. El proyecto usa reconstrucciones por nube de puntos y un sistema de posicionamiento visual (VPS) para anclar las escenas y los personajes a la calle.
El proyecto se realiza con el Huntington-USC Institute on California and the West, la Chinese Historical Society of Southern California, Metro Art y Union Station, con el apoyo de una beca de prototipado del National Endowment for the Humanities.
La capa de conocimiento detrás de los personajes.
La experiencia de realidad aumentada, las escenas de calle, el trabajo de nube de puntos y VPS y el diseño en el sitio son obra del laboratorio con sus colaboradores.
Mi contribución es la capa de conocimiento detrás de los personajes, construida con el equipo. Convierto las historias orales y el archivo del proyecto en conocimiento: ordeno el material, clasifico cada fuente según el tipo de evidencia que es y etiqueto cada elemento con metadatos, para que un modelo de lenguaje basado en recuperación pueda responder a partir de él con precisión. También diseñé cómo se gobiernan las bases de conocimiento en un proyecto donde muchos personajes hablan por una sola comunidad: qué entra en la base de conocimiento propia de cada personaje, qué entra en la memoria compartida de la que todos se nutren y qué puede entrar en absoluto. Junto a esto construyo herramientas de IA que conectan los recursos del proyecto entre las plataformas que usa el equipo.
No son solo decisiones técnicas. Los personajes hablan por una comunidad cuyo barrio fue demolido para dejar sitio a Union Station, y mucho de lo que sobrevive de él fue escrito por otros: periódicos, registros municipales, las colecciones de instituciones. Las historias orales son el relato propio de la comunidad, y llegan más tarde y desde la memoria. Clasificar cada fuente por su tipo es una forma de decir desde qué relato puede hablar un personaje y cuál solo puede referir, y mantener un clip fuera hasta que quien habla en él haya dado permiso es una forma de decir de quién se necesita el consentimiento antes de usar un registro.
La pregunta en la que trabajo aquí es cómo guardar los registros dispersos de una comunidad para que sus personajes respondan a partir de ellos con precisión, en los lugares que esos registros describen.
De las historias orales al conocimiento.
Memory Space usa el mismo flujo de procesamiento de ingesta que el Immersive Archive, organizado en torno a una clave distinta. En el Immersive Archive una carpeta es una caja de los papeles de Heilig. Aquí una carpeta es un lugar.
El material
La unidad de investigación del proyecto contiene más de tres mil archivos, ordenados tal como se hizo la investigación: periódicos, fotografías, mapas y registros municipales, cada tipo en su propia carpeta, con las historias orales al lado. La experiencia de realidad aumentada está organizada por lugar, así que el material sobre una dirección estaba repartido entre todas ellas. El plan que propuse lo reagrupa por lugar, de zona a calle a dirección, con una carpeta aparte para las cartas y discursos propios de cada personaje.
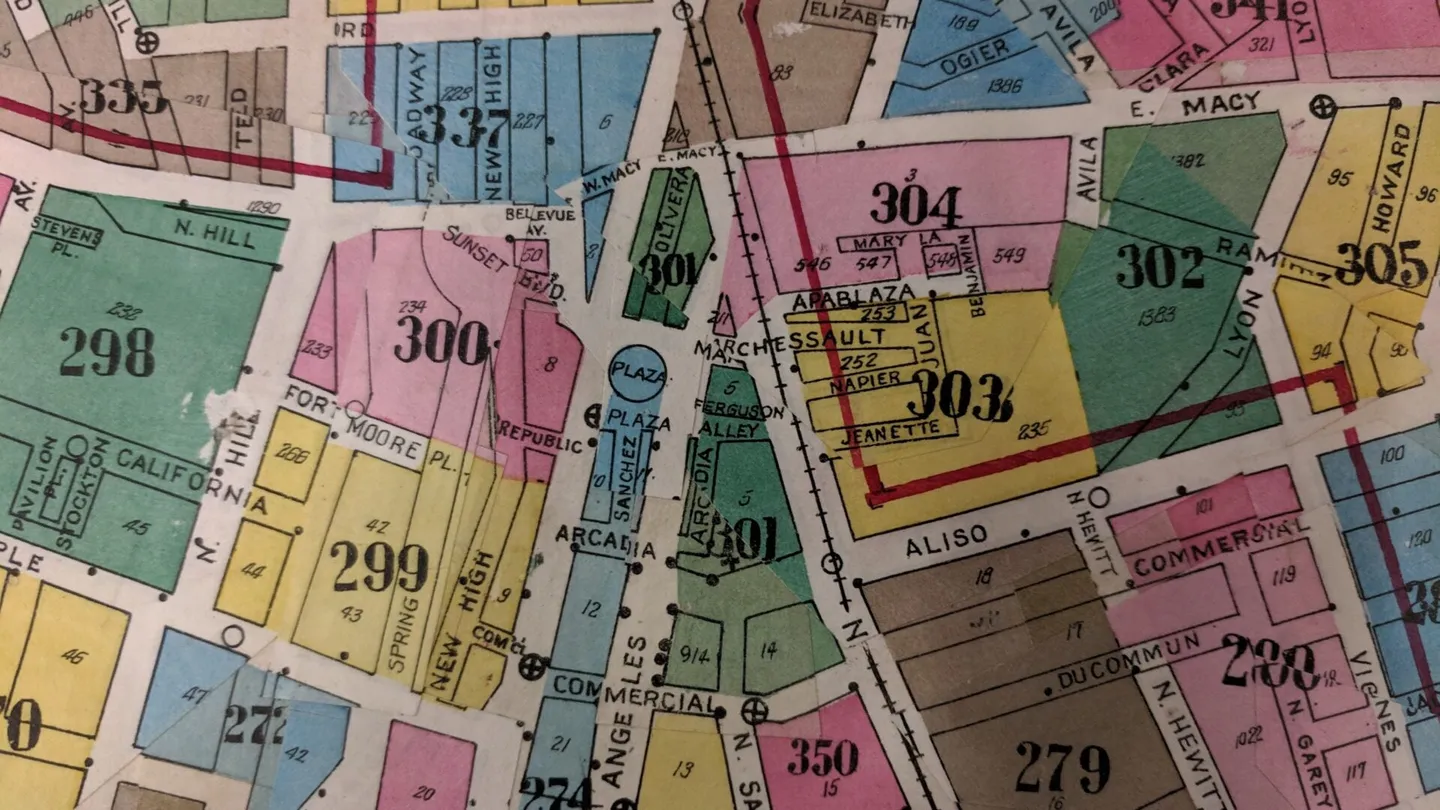
- Archivos en la unidad de investigación
- 3,000+
- Ordenados por
- Fuente
- Reagrupados por
- Lugar
Base de conocimiento de memoria compartida
- Old Chinatown
- Apablasa Street
- Una dirección en la calle
- Marchessault Street
- Apablasa Street
- Nuevo Chinatown
- Referencia
- Archivos de trabajo, nunca ingeridos
La base de conocimiento de un personaje
- Cartas y discursos
Una búsqueda de Apablasa Street también encuentra los archivos guardados bajo las direcciones de esa calle.
Historias orales
Las historias orales son el relato propio de la comunidad y el material más difícil de guardar bien. Las grabaciones se transcriben a partir del habla. Cada una se fecha por la época que describe, así que una entrevista hecha décadas después sobre los años veinte se fecha en los años veinte. Los clips que aún necesitan permiso quedan fuera de la base de conocimiento hasta que se concede. Los recuerdos también se clasifican aparte de los registros hechos en su momento, para que un personaje pueda distinguir unos de otros.
Clasificar las fuentes
A cada elemento se le asigna un nivel que dice qué tipo de evidencia es, y el nivel decide cómo puede usarlo un personaje. Cuando un personaje habla en primera persona, se basa solo en fuentes primarias.
Primaria
Hecha en su momento: cartas, registros, fotografías.
Historia oral
Recordada y grabada más tarde.
Nota de investigación
Las notas propias del equipo sobre el material.
Secundaria
Escrita más tarde sobre la comunidad, como los trabajos académicos.
Metadatos en cada elemento
Cada elemento lleva los mismos campos, guardados en una hoja de inventario y escritos en su entrada de la base de conocimiento. Algunos campos tienen niveles, así que una búsqueda puede detenerse en cualquiera de ellos: un lugar va de zona a calle a dirección, y una fuente de institución a colección a caja y carpeta.
Bases de conocimiento de personajes y una memoria compartida.
Memory Space es un proyecto comunitario: muchos personajes hablan por un solo barrio. Cada personaje tiene una base de conocimiento propia, para las cartas, discursos y biografías de esa persona. Todos se nutren de una base de conocimiento de memoria compartida que guarda lo que pertenece al barrio en su conjunto, desde registros de calles hasta historias orales. Un archivo que trata sobre todo de un lugar va a la memoria compartida, aunque nombre a un personaje.
Límites de la búsqueda de un personaje
Según el diseño, la búsqueda de un personaje está limitada de varias maneras a la vez, cada una fijada por los metadatos.
Bases de conocimiento
La suya propia y la memoria compartida.
Fecha
Solo material fechado antes del año de su escena.
Lugar
Acotada al lugar donde está el visitante.
Primera persona
Solo a partir de fuentes primarias.
Reglas antes de que entre nada
La mayor parte de la gobernanza ocurre antes de que intervenga ningún modelo. Revisar las unidades mostró qué hay que resolver primero.
Estado
Cada elemento se marca como incluir, excluir, duplicado o revisar. Solo entran los elementos incluidos con los derechos resueltos.
Procedencia
De dónde vino un archivo a menudo sobrevive solo en el nombre de una carpeta, así que se registra antes de mover nada.
Derechos
Los clips de historia oral que aún necesitan permiso quedan fuera hasta que se concede.
Tipo de registro
Muchos archivos guardados como fotografías son capturas con el teléfono de registros de archivo. Se transcriben como cualquier otro documento.
No listo
Las carpetas marcadas para no ingerir se quedan en la unidad y nunca se escanean.
Guardar los registros de una comunidad.
En el Immersive Archive el agente habla como un solo inventor con un rastro documental. Aquí los personajes representan a una comunidad, y los registros son parciales y están en manos de varias instituciones: la Huntington Library, archivos municipales, periódicos y las historias orales del propio proyecto. Todo lo que dice un personaje tiene que poder rastrearse hasta algo en la colección. Los vacíos de la colección hay que tratarlos con cuidado, porque son parte de la historia de este barrio.
Comprobar los personajes
La evaluación construida para Mort en el Immersive Archive, fidelidad al archivo y fidelidad al personaje, está previsto aplicarla también a un lugar de Memory Space, para ver en qué se diferencia responder por un lugar documentado de responder como una persona documentada.
Personajes en las escenas de calle, a partir de la primavera de 2027.
El siguiente paso, previsto para la primavera de 2027, es llevar los personajes a la compilación del motor, dentro de las escenas de calle, con el archivo accesible desde la propia escena. Se planean dos tipos de recuperación: una que sigue a una persona o un tema a través del material que los documenta, y otra por ubicación, de modo que lo que un personaje puede alcanzar dependa de dónde está el visitante.
La meta mayor es la experiencia completa en Union Station: visitantes que se encuentran con personajes que responden a partir de los propios registros de la comunidad, en los lugares que esos registros describen. Los resultados se irán listando aquí a medida que el proyecto los publique.