老唐人街,回到原来的地方。
Memory Space 把洛杉矶最早那片唐人街的历史放回原址,那里的角色凭社区自己的记录来回答访客。
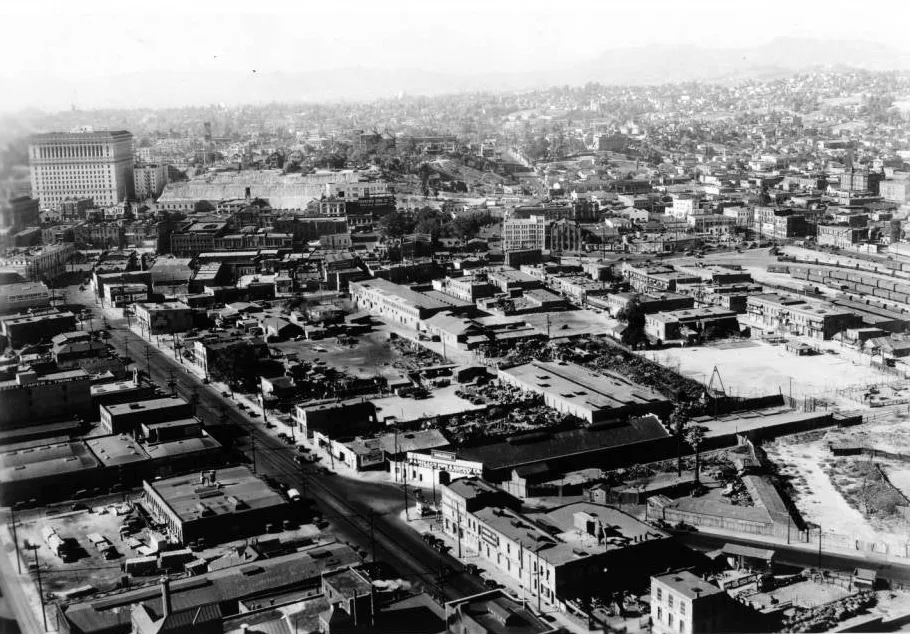
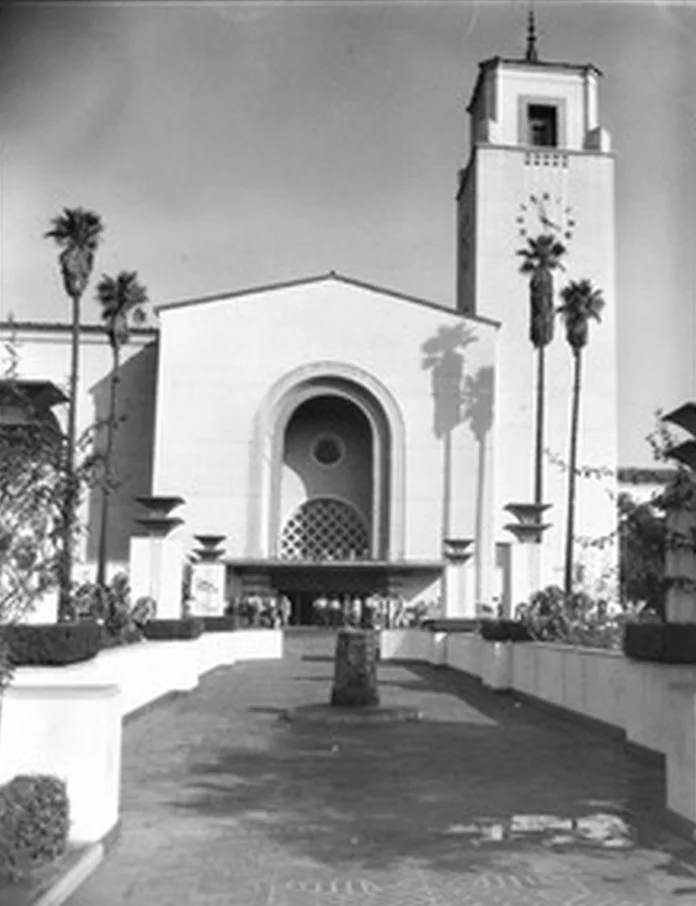
Memory Space: Chinatown AR 是 USC Mobile and Environmental Media Lab 的移动增强现实项目,由 Scott Fisher 和 William Deverell 主持。访客站在 Union Station,举起手机,就能看到洛杉矶最早那片唐人街的老照片,一张张叠在当年拍摄它们的位置上,等于沿着老摄影师的脚印重走一遍。传送门打开后,是这个消失社区的三维街景,访客在街景里遇到可以互动的角色。场景和角色要固定在真实的街道上,靠的是点云重建和视觉定位系统(VPS)。
合作方有 Huntington-USC Institute on California and the West、Chinese Historical Society of Southern California、Metro Art 和 Union Station,另有 National Endowment for the Humanities 的一笔原型开发资助支持。
角色背后的知识层。
AR 体验、街景、点云和 VPS,还有现场的设计,这些是实验室和合作方做的。
我负责的是角色背后的知识层,和团队一起做。具体说,就是把项目的口述史和档案整理成知识:先把材料分类,再按每份来源算哪一种证据来分级,最后给每个条目加上元数据,这样基于检索的语言模型才能准确地凭它作答。这个项目里有很多角色,替同一个社区说话,所以知识库怎么管也是我设计的:哪些东西进某个角色自己的知识库,哪些进大家共用的共享记忆,哪些根本不该进来。另外我还做一些 AI 工具,把项目素材在团队用的几个平台之间连起来。
这些决定不只是技术问题。角色替一个社区说话,这个社区的街区当年为了给 Union Station 让地被拆掉了,留下来的材料大多是别人写的:报纸、市政记录、各机构的馆藏。口述史才是社区自己的说法,但年代晚,而且凭的是记忆。给每份来源分级,其实是在定一件事:哪些说法角色可以当作自己的话讲,哪些只能转述。一段录音在讲述者点头之前不许进知识库,也是在定一件事:一份记录要用,得先经过谁的同意。
我在这里琢磨的问题是:一个社区零零散散的记录,要怎么保存,角色才能在记录所讲的那些地点上,准确地凭这些记录作答。
从口述史到知识。
Memory Space 用的导入流水线和 Immersive Archive 是同一套,只是组织的依据换了。在 Immersive Archive 里,一个文件夹对应 Heilig 文稿的一个箱子;在这里,一个文件夹对应一个地点。
材料
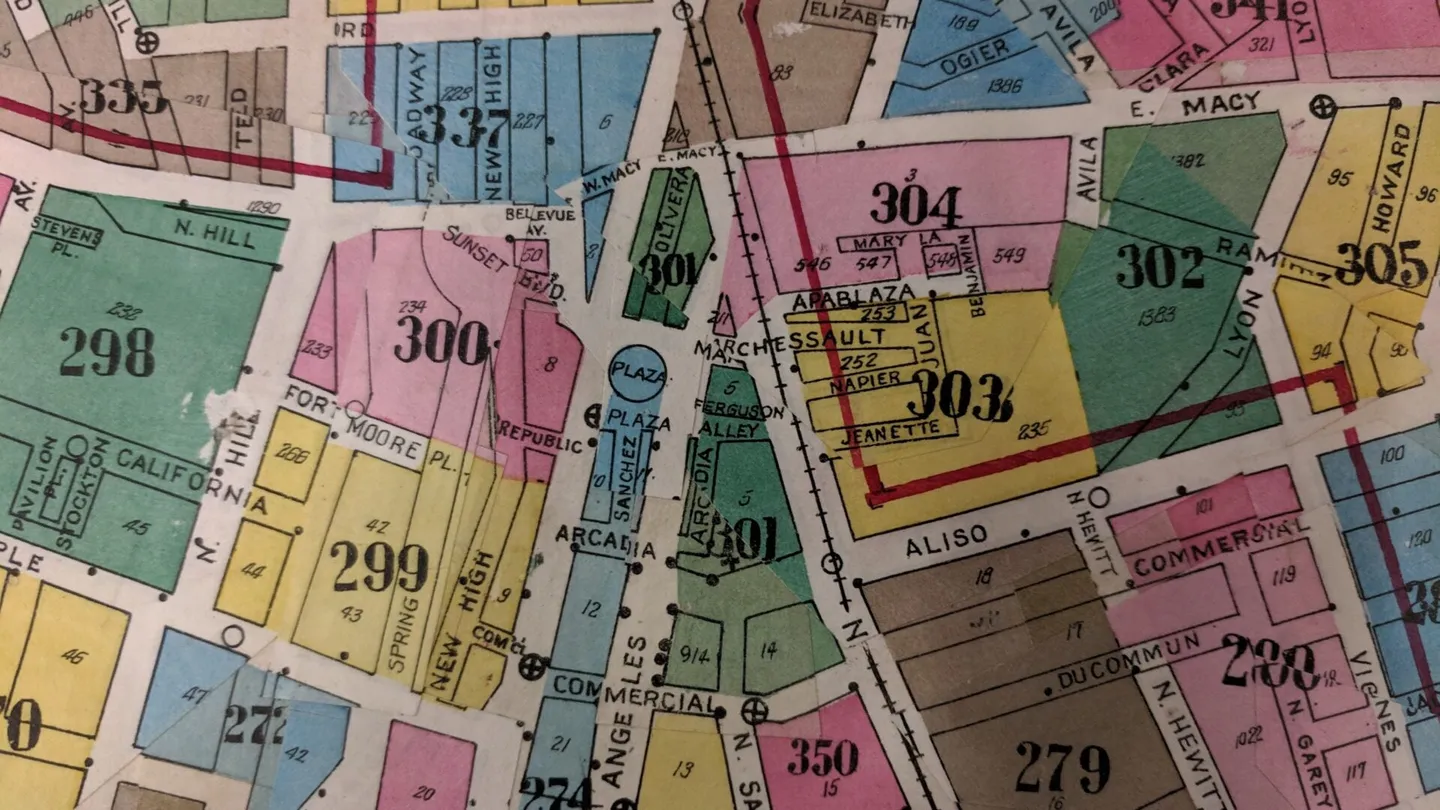
项目的资料盘里有三千多个文件,是按研究的路数分的:报纸、照片、地图、市政记录各占一个文件夹,口述史放在旁边。可是 AR 体验是按地点组织的,于是关于同一个地址的材料散在所有文件夹里。我提的方案是按地点重新分组,从片区到街道再到地址,每个角色自己的信件和演讲另开一个文件夹。
- 资料盘里的文件
- 3,000+
- 原来按
- 来源
- 现在按
- 地点
共享记忆知识库
- Old Chinatown
- Apablasa Street
- 街上的某个地址
- Marchessault Street
- Apablasa Street
- New Chinatown
- 参考资料
- 工作文件,不导入
某个角色的知识库
- 信件和演讲
搜 Apablasa Street,这条街上各个地址下面的文件也会一起找出来。
口述史
口述史是社区自己的说法,也是最难保存好的材料。录音先转成文字。日期按它讲的是哪个年代来标,所以几十年后做的采访,只要讲的是 1920 年代,就标成 1920 年代。还没拿到许可的片段先不进知识库,拿到了再进。回忆和当年留下的记录分开分级,角色才分得清哪个是哪个。
给来源分级
每个条目都定一个等级,说明它是哪一种证据;角色能怎么用它,由等级决定。角色用第一人称说话时,只能用一手来源。
一手来源
当时留下的:信件、记录、照片。
口述史
事后回忆、事后记下的。
研究笔记
团队自己对材料做的笔记。
二手来源
后人写这个社区的东西,比如学术研究。
每个条目的元数据
每个条目都带同一组字段,一份记在清单表里,一份写进它在知识库里的条目。有些字段分层,搜索可以停在任何一层:地点从片区到街道到地址,来源从机构到馆藏到箱子和文件夹。
角色知识库与共享记忆。
Memory Space 是一个社区项目:很多角色,替同一个街区说话。每个角色有自己的知识库,放这个人的信件、演讲和传记。所有角色还共用一个共享记忆知识库,放属于整个街区的东西,从街道记录到口述史。一份文件如果主要讲的是地点,就算提到了某个角色,也归到共享记忆里。
角色的搜索范围
按设计,角色搜索时同时受几重限制,每一重都由元数据来定。
知识库
自己的那个,加上共享记忆。
日期
只看日期早于角色所在年份的材料。
地点
收窄到访客站的位置。
第一人称
只用一手来源。
进门之前的规则
管理的大部分工作,在模型还没登场之前就做完了。把盘里的东西翻过一遍,就知道哪些事得先定下来。
状态
每个条目标成纳入、排除、重复或待审四种之一。只有标了纳入、权利也清了的才能进。
出处
一个文件从哪来,往往只剩文件夹名字里那点线索,所以动任何东西之前先把它记下来。
权利
还没拿到许可的口述史片段先留在外面,拿到了再进。
记录类型
不少存成照片的文件,其实是用手机翻拍的档案记录。它们和别的文档一样要转写。
未就绪
标了不导入的文件夹留在盘里,从不扫描。
保存一个社区的记录。
Immersive Archive 里的智能体扮演一位发明家,一个人,留下了一整套文稿。这里的角色代表的是一个社区,记录残缺不全,还分散在几处:Huntington Library、市政档案、报纸,以及项目自己做的口述史。角色说的每一句话都得能追到馆藏里的某一份材料。馆藏里的空白要小心对待,因为空白本身也是这个街区历史的一部分。
核对角色
Immersive Archive 里为 Mort 做的那套评估,也就是档案忠实度和角色忠实度,计划也拿到 Memory Space 的一个地点上跑一遍,看看替一个有记录的地方作答,和扮演一个有记录的人作答,有什么不同。
2027 年春天起,角色进入街景。
下一步定在 2027 年春天:把角色放进引擎版本,站到街景里面去,在场景里就能查档案。检索打算做两种:一种顺着一个人或一个题目往下找,把记录他们的材料翻出来;另一种按位置,角色能碰到什么,取决于访客站在哪里。
更远的目标是 Union Station 的完整体验:访客在记录所讲的那些地点,遇到凭社区自己的记录说话的角色。项目有成果发布,会陆续列在这里。